Гораздо эффективнее учитываются статистические связи между элементами изображения по методу предсказания. Здесь используют то обстоятельство, что, зная соседние предшествующие элементы изображения, можно значительно лучше предсказать последующие, чем если соседние элементы не были бы известны.
Пусть уже известна группа из v — 1 элементов изображения. Обозначим эту группу через Di, а условную вероятность того, что примыкающий к этой группе v-й элемент имеет (если известно значение всех v — 1 элементов группы) яркость j, через pDi(j). Значение j может быть от 1 до m, где m — число возможных градаций яркости. Следует подчеркнуть, что вероятность того, что данный элемент имеет j-ю градацию яркости, когда ничего не известно о соседних элементах, р (j) может резко отличаться от pDi(j). Так, для изображений такого типа, как на рис. 31, а, р (0) = р (1) = 0.5, т. е. р (j) — 0.5 (j = 0; 1), черные и белые элементы в среднем встречаются одинаково часто. Если взять v = 4 и в качестве групп Dj выбирать тройки соседних элементов, расположенных так, как на рис. 32, а (элементы 1, 2, 3), то, например, при условии, что все элементы 1,2,3 — черные, четвертый предсказываемый элемент окажется приблизительно в 43 раза чаще черным, чем белым. Это видно из таблицы 4, где первому случаю соответствует группа из четырех элементов В1й, а второму — 2?13. Только при отсутствии статистических связей вероятность pDi(j) тождественно равна р (j).
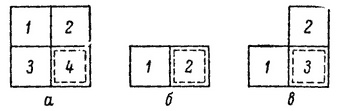
Рис. 32. Примеры (а—е) выбора групп предшествующих элементов. Предсказываемый элемент отмечен пунктиром.
В соответствии с основным определением для информации количество информации, которое содержится в сообщении, что v-й элемент имеет j-ю градацию, если уже известна группа из v — 1 элементов, обозначенная будет — log pDi(j). Для того чтобы найти соответствующее приближение к энтропии изображения, т. е. количество информации на один элемент при учете статистических связей между группой из v — 1 элементов и v-м элементом, остается найти среднее значение — log pDi(j). Для этого надо знать еще вероятность появления группы j),. из v — 1 элементов, сопровождаемой v-m элементом, имеющим значение j. Обозначим эту вероятность р (Di, j). Она вычисляется из
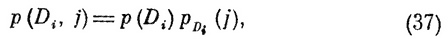
где р (Di) — вероятность, с какой может встретиться в изображении группа Df из v — 1 элементов. Среднее значение — log pDi(j) будет, согласно известному правилу нахождения среднего значения величины, суммой произведений значений этой величины на вероятность этих значений для всех возможных значений i и j. Это обозначается следующим равенством
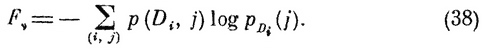
Легко заметить, что при v = 1 оба приближения к энтропии тождественно равны, F1 = G1. Шеннон (Shannon a. Weaver, 1949) показал, что приближение к энтропии Fу стремится к H с ростом v быстрее, чем Gv, так что всегда Fv≤Gv. Вообще говоря, Н является пределом Fv, при бесконечном увеличении числа v. Однако если статистическое влияние, распространяющееся больше чем на v элементов, отсутствует, иными словами, если условная вероятность появления следующего элемента при условии знания v —1 элементов не изменяется при ознакомлении с другими любыми элементами, то F4 = H уже при конечном значении v.
Большое значение имеет формула, позволяющая вычислить Fy, если известны Gv,
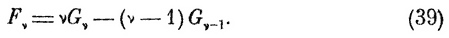
Поэтому оказывается достаточным для получения хорошего приближения к энтропии измерить Gv для сравнительно небольших значений v.
Шрейбер (Shreiber, 1956) определил третье, а Лебедев (1958) — четвертое приближение к энтропии для нескольких типов изображений. На рис. 33, построенном по данным Лебедева, показана характерная зависимость приближения к энтропии от номера v. В качестве нулевого приближения указано значение Hмакс = log28 = 3 дв. ед. Значение Fl (v=1), равное G1 представляет собой энтропию одномерного распределения, полученную по формуле (35). Второе приближение соответствует F2 (v=2) — предсказанию последующего элемента по предыдущему (рис. 32, б). Это приближение представляет собой среднее значение логарифма вероятности градации яркости данного элемента (2 на рис. 32, б), когда уже известна яркость предыдущего (1 на том же рисунке). Третье приближение F3 (v=3) соответствует предсказанию третьего элемента по двум соседним, располоягенным, как 1 и 2 на рис. 32, в. Наконец, четвертое приближение соответствует предсказанию четвертого элемента по трем смежным (рис. 32, а). Зависимость Fv от v, полученная для других сюжетов другими авторами, имеет такой же характер (Powers a. Staras, 1957).
Прежде всего следует отметить резкое изменение Fv при переходе от v=1 к v=2. Знание предыдущего элемента существенным образом влияет на вероятность последующего. Можно эффективно предсказывать последующий элемент, зная предыдущий. Достаточно хорошее предсказание состоит в том, что яркость последующего элемента будет такая же, как у предыдущего. Значительная часть информации об изображении как бы сосредоточена в переходах.
Это иллюстрируется таблицей 5 (Лебедев, 1958). Там показано распределение вероятностей рi (j) (точнее, частот), того, что последующий элемент имеет градацию j, если предыдущий имел градацию i. В случаях, когда величина рi (j) была меньше 10-4, ячейку таблицы оставляли незаполненной. Видно, что наибольшие, резко отличающиеся от других значения рi (j) при заданном i достигаются, когда j—i, т. е. яркость последующего элемента равна яркости предыдущего.
ТАБЛИЦА 5
| Градация предшествующего элемента (i) | Градация последующего элемента (j) | |||||||
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
| 1 | 0.0027 | 0.0010 | ||||||
| 2 | 0.0008 | 0.0062 | 0.0024 | |||||
| 3 | 0.0022 | 0.0138 | 0.0034 | 0.0003 | ||||
| 4 | 0.0030 | 0.0093 | 0.0040 | 0.0003 | ||||
| 5 | 0.0004 | 0.0030 | 0.0154 | 0.0081 | 0.0002 | |||
| 6 | 0.0002 | 0.0006 | 0.0063 | 0.1520 | 0.0321 | 0.0004 | ||
| 7 | 0.0006 | 0.0303 | 0.3454 | 0.0221 | ||||
| 8 | 0.0003 | 0.0210 | 0.3120 | |||||
Другой важный вывод состоит в том, что, когда уже известен один предшествующий элемент, знание еще одного или двух элементов практически мало влияет на вероятность значения яркости предсказываемого элемента. F3 и F4 несущественно отличаются от F2. Таким образом, особенно важно учесть статистические связи между данным и соседним элементами.
Статистика изображений в приближениях, когда n>4, почти не изучена. Однако можно предполагать, что при дальнейшем увеличении n величина Fn будет медленно уменьшаться по мере того, как будут учитываться статистические связи между все более и более удаленными элементами в зрительных образах, отражающие глубокие взаимосвязи в объектах внешнего мира.
Сходным образом могут быть рассмотрены статистические связи между элементами изображения во времени. При наблюдении естественных сюжетов с движением (естественных, в том смысле, что не учитываются перемещения искусственных, созданных человеком объектов, таких, как современные средства транспорта и пр.) статистические связи становятся особенно заметными при интервалах времени порядка 0.1 сек. и менее. Значение этого порядка величины уже обсуждалось в связи с временным накоплением.
В частности, исследования статистических связей между соседними телевизионными и кинокадрами в пределах одного сюжета и при исключении сцен с наездом и панорамированием показали, что в среднем лишь несколько сотых долей от общего числа элементов восьми,- десятиградационного изображения изменяют свою яркость от кадра к кадру на одну градацию и более (Арбузов, Берлин, Цуккерман, 1959). Эффективное предсказание последующего элемента (через указанный временной интервал) состоит в том, что яркость последующего во времени элемента будет такая же, как у предыдущего.
Имеющиеся в нашем распоряжении данные о статистике изображений позволяют оценить информацию, содержащуюся в изображениях, лишь в первом приближении. Прежде всего предполагалось, что получатель изображения производит выбор из определенного набора возможных изображений, имеющих заданное число элементов, каждый из которых может принимать любую из заданного числа градацию яркости. При этом количество информации, приходящееся в среднем на элемент изображения, оказывалось значительно меньше (в несколько раз для широкого класса изображений, а для некоторых более узких классов — более чем на порядок), чем та информационная емкость, которая приходится на один элемент при обычном представлении изображений. Такие оценки более точны для техники передачи изображений. В случае, когда получателем изображений является зрительная система, оценка информации, содержащейся в изображении, существенно завышена. Действительно, мы не учли, что число различаемых глазом градаций яркости зависит от размеров рассматриваемых объектов. Это число больше для крупных однородных участков и меньше для границ (контуров и мелких деталей). Уже по этой причине нельзя считать «алфавит» зрительной системы заданным максимально различимым числом градаций яркости.
Мы не учли также глубоких статистических связей, существующих внутри зрительных образов. Если для периферии зрительного анализатора (для сетчатки) в какой-то мере правильно полагать, что алфавит определяется различимыми градациями яркости, то уже для высших отделов зрительного анализатора это оказывается неверным. Мозг производит выбор в первую очередь из больших совокупностей элементов — из набора зрительных образов. К этому мы также вернемся в последней главе и покажем, что информация, в действительности содержащаяся в изображении при условии, когда получателем является мозг, значительно меньше, чем та, которая могла бы быть оценена по статистике небольших соседних групп элементов.
И все же исследование статистических свойств изображений в рассмотренном приближении полезно для понимания функциональной организации зрительного анализатора. В дальнейшем, в связи с обсуждением проблемы статистического кодирования изображений, мы убедимся в том, что эти статистические свойства хорошо учтены в зрительной системе, замечательным образом приспособленной к извлечению информации из изображений.
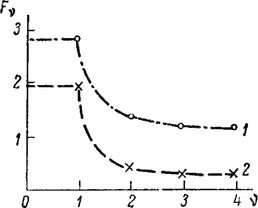
Рис. 33. Приближения к энтропии для некоторых типовых изображений, проквантованных на 8 градаций.
1 — детальное изображение (стадион, трибуны, общий план); 2 — портрет (крупный план).